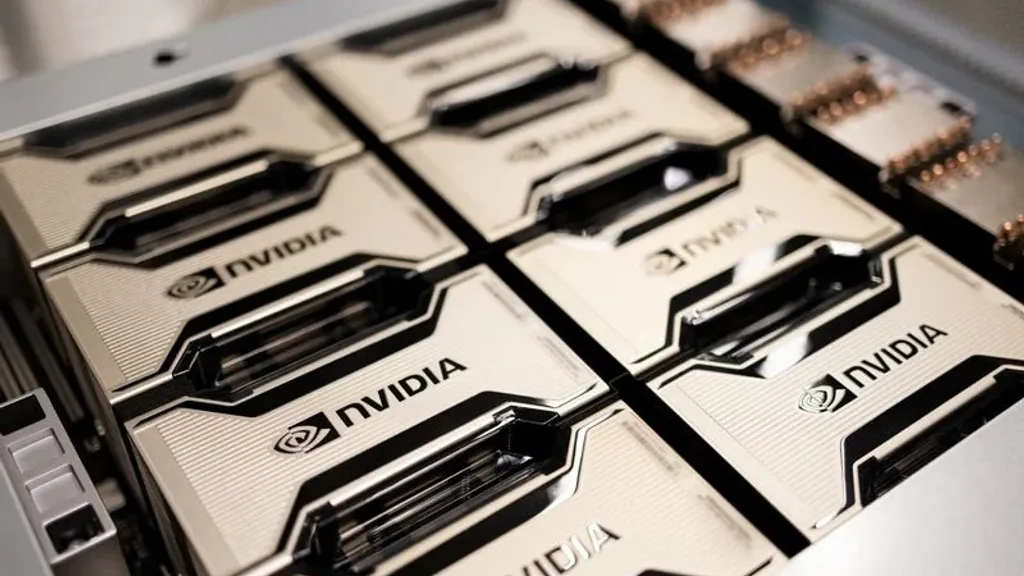
NVIDIA’nın 2017’de tanıttığı Volta mimarisini kullanan Tesla V100, dört GPU’lu bir kurulumda yapılan yapay zeka testlerinde daha yeni sistemlerin önüne geçti. Jun Yamog’un hazırladığı düzenek, Qwen3.8-Flash-Next modelinde uzun istemleri işlerken M5 Ultra’dan yüzde 230, iki DGX Spark’tan oluşan kümeden ise yüzde 40 daha hızlı sonuç verdi.
Testte kullanılan Tesla V100’lerin her biri 32 GB HBM2 belleğe ve 900 GB/sn bellek bant genişliğine sahip. Ancak bu donanımları birlikte çalıştırmak, yalnızca dört GPU’yu aynı sisteme yerleştirmekle sınırlı kalmadı. Yamog, bağlantı ve soğutma tarafında ek donanım ile fiziksel düzenlemelere başvurdu.
Dört GPU için NVLink bağlantısı ve özel soğutma
Kurulumun merkezinde, dört ayrı V100’ü bir araya getiren bir NVLink taşıyıcı kart bulunuyor. Altı NVLink 2.0 bağlantısı üzerinden 300 GB/sn bant genişliği sunan bu kart, GPU’ların birlikte kullanılmasını sağladı. Taşıyıcı kartın sisteme bağlantısı ise geçiş adaptörleri yardımıyla PCIe x8 üzerinden yapıldı.
GPU’ları karta monte etmenin yanında, her birinin ürettiği ısıyı uzaklaştırmak da çözülmesi gereken bir sorundu. Yamog bunun için NVIDIA A100’e ait soğutucuları kullandı. Soğutucular, frezeleme işlemiyle V100’ün yapısına uyacak biçimde değiştirildi.
Bu işlemden sonra büyük soğutucular, her çipin ürettiği 300 W’lık ısı yükünü karşılayabildi. Dolayısıyla ortaya çıkan sistem, ek taşıyıcı kart ve değiştirilmiş soğutucular içeren, fiziksel olarak büyük bir düzenek oldu. Elde edilen performans sonuçlarının arkasında bu kurulum çalışması da bulunuyor.
İstem işleme ve token üretiminde farklı sonuçlar
Karşılaştırmada dört V100’ün karşısına iki DGX Spark ve tek bir M5 Ultra çıkarıldı. DGX Spark cihazları 128 GB LPDDR5X birleşik belleğe sahipti. Yapay zeka modeli olarak Qwen3.8-Flash-Next kullanıldı ve model, 4 bit nicemleme ile çalıştırıldı.
Uzun istemlerin işlenmesinde V100 kümesinin iki DGX Spark’a karşı sağladığı yüzde 40’lık avantaj, kısa istemlerde de korundu. M5 Ultra ile arasındaki fark ise istem uzunluğuna göre değişti: Uzun istemlerde yüzde 230 olan hız üstünlüğü, kısa istemlerde yüzde 163 olarak ölçüldü.
Yamog, Apple Silicon tarafındaki büyük performans farkının muhtemelen yazılım optimizasyonlarının eksikliğinden kaynaklandığını belirtti. Bu değerlendirme, M5 Ultra’nın testteki sonucunu yorumlarken yazılımın da hesaba katılması gerektiğine işaret ediyor; farkın yalnızca donanımdan kaynaklandığı kesinleştirilmiş değil.
Kısa istemlerde token üretimi ölçüldüğünde dört V100, saniyede 100,6 token seviyesine ulaştı. Bu sonuç, iki DGX Spark’ın oluşturduğu sistemden yüzde 121 daha hızlıydı. Alex Ziskind’in paylaştığı sonuçlarla yapılan karşılaştırmada M5 Ultra için saniyede 44,5 token değeri yer aldı.
Karşılaştırmaya Ziskind’in sekiz RTX PRO 6000 GPU’dan oluşan sistemi de dahil edildi. Bununla birlikte, aktarılan sayısal sonuçlar V100 kümesinin M5 Ultra ve iki DGX Spark karşısındaki performansına odaklanıyor. İstem işleme ile token üretimi için ayrı ölçümler veriliyor.
Eski veri merkezi GPU’ları yerel modellerde kullanılıyor
Tesla V100’ün büyük dil modelleri için yeniden değerlendirilmesi bu kurulumla sınırlı değil. Başka bir kullanıcı da V100’ünü değiştirerek aynı kasada RTX 4080 ile birlikte çalıştırdı. Ek video belleği ve bant genişliği sayesinde bu sistemde 27 milyar parametreli yapay zeka modelleri kullanılabildi.
Donanımın edinme maliyeti de yerel yapay zeka sistemi kurmak isteyenler açısından karşılaştırmanın bir parçası. Tesla V100’ün 32 GB sürümü için eBay’de 744 dolarlık fiyat örneği veriliyor. İki kart kullanımı, daha büyük modelleri çalıştırma olanaklarını genişletiyor. Dört kartlı test düzeneği ise performansın yanında taşıyıcı kart, soğutma değişiklikleri ve daha büyük fiziksel alan gereksinimini de ortaya koyuyor.